Ressources numériques en sciences humaines et sociales OpenEdition Nos plateformes OpenEdition Books OpenEdition Journals Hypothèses Calenda Bibliothèques OpenEdition Freemium Suivez-nous

Samuel Salgado (CENFOTO-UDP): recursos y plataformas compartidas

Durante la visita del colega Samuel Salgado (Universidad Diego Portales, Chile) a Paris 8, nos presentó parte de sus trabajos vinculados a preservación, digitalización y análisis de documentos/imagen. Aquí hay un registro de enlaces para mantener evidencia y archivo de los recursos compartidos.


1) ARPA UDP – Archivo de la Palabra Impresa (ejemplo: “La Patria”, 10/08/1974)

Entrada específica (ficha archivística + objeto digital):
https://arpa.udp.cl/index.php/la-patria-10-de-agosto-de-1974

  • Título del ítem: La Patria – 10 de agosto de 1974
  • Código de referencia: CL UDP CENFOTO AMCI-FDLN-P-LP-1974-AGOSTO-LP_1974_08_10_flat
  • Tipo: “Periódico completo” (digitalizado)
  • Descarga directa (PDF): LP_1974_08_10_flat.pdf
  • Imagen de referencia (portada): LP_1974_08_10_flat_141.jpg

Nota de uso: esta plataforma permite navegar por prensa histórica custodiada por UDP/CENFOTO; conviene registrar siempre el código de referencia y el nombre del archivo descargado.


2) CENFOTO UDP – Noticia institucional sobre FONDEQUIP (ANID) y laboratorio

Noticia:
https://cenfoto.udp.cl/por-primera-vez-udp-se-adjudica-convocatoria-del-fondequip-mediano-anid/

  • Describe la adjudicación de FONDEQUIP mediano 2024 (ANID) para una plataforma avanzada de digitalización en CENFOTO-UDP.
  • Se menciona la incorporación de un escáner DT BC-100 y tecnologías de análisis de datos de texto e imagen.
  • Enmarca el proyecto en principios de ciencia abierta y acceso público, con colaboración interinstitucional.
  • Referencia a estándares de calidad para digitalización patrimonial (p. ej., FADGI, Metamorfoze e ISO 19264-1).
  • Se indica que los documentos digitalizados se integrarán en plataformas como culturadigital.udp.cl y datos.udp.cl.

3) Equipo / referencia técnica: DT BC100 (sistema de digitalización de libros)

Ficha del producto:
https://heritage-digitaltransitions.com/product-catalog/dt-bc100/

  • Descripción general: sistema de captura para material encuadernado y suelto, con doble cámara (alta producción y calidad).
  • Compatibilidades/formatos: salida en TIFF/JPEG/PDF (según configuración del sistema).
  • Elementos de cuidado del material: platina de vidrio (ángulo 100°) y opciones de soporte/cuna neumática (según configuración).
  • Especificaciones físicas (ver ficha): dimensiones, huella, limitación de lomo, etc.
  • Útil como referencia para discutir: infraestructura, estándares y flujos de trabajo de digitalización patrimonial.

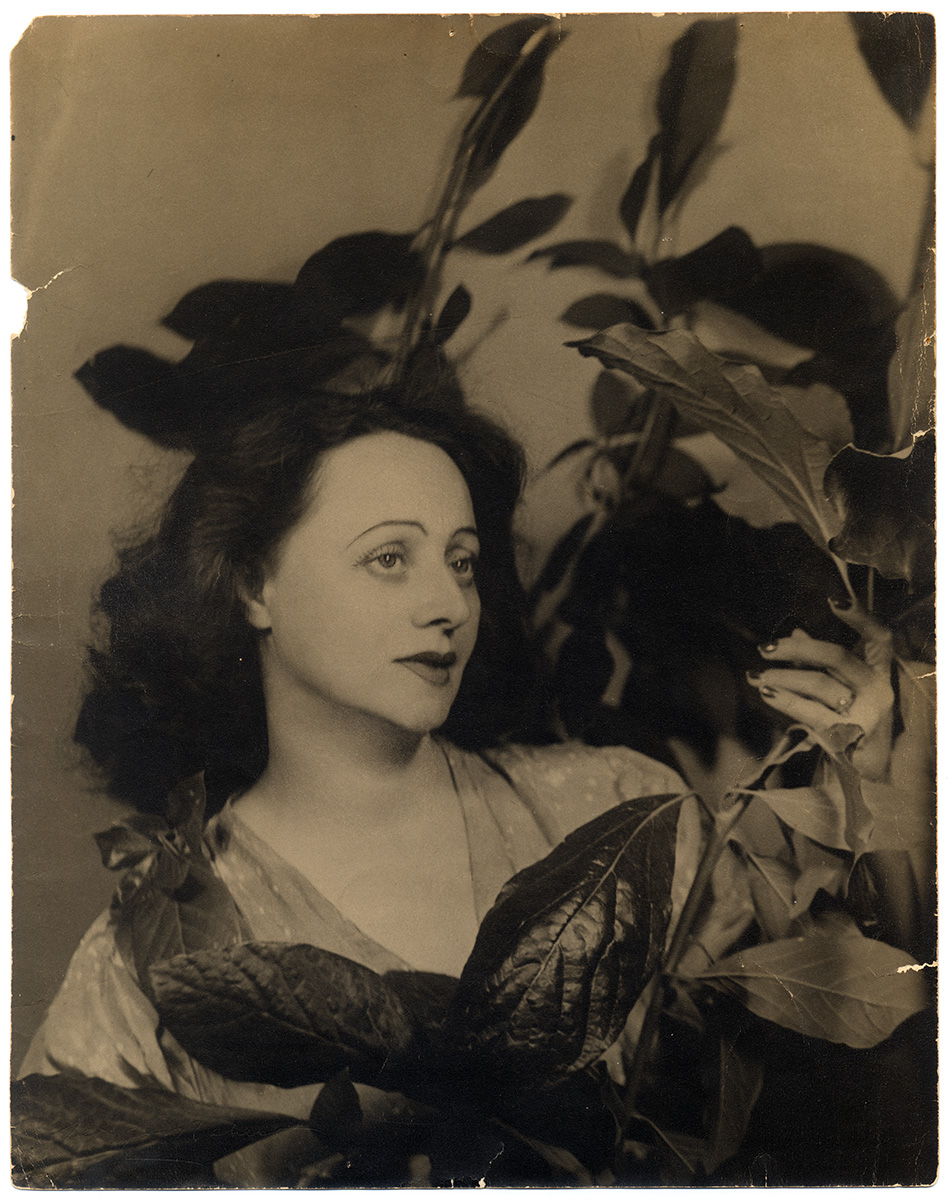
4) Cultura Digital UDP – Ejemplo de objeto fotográfico (“Retrato de mujer”)

Ficha del objeto:
https://culturadigital.udp.cl/fotografia/retrato-de-mujer-29/

  • Fondo: Fondo Sady Zañartu
  • Código: FD-000276
  • Descripción breve (según ficha): retrato de busto de una mujer posando entre plantas (mirada hacia la derecha).
  • Descarga directa (JPG): FD-000276.jpg
  • La ficha también ofrece opción para solicitar en alta resolución (según procedimientos/condiciones del repositorio).

5) Datos UDP – Plataforma de búsqueda en corpus (N-grams / prensa histórica)

Acceso:
https://datos.udp.cl/busqueda/

Enlaces útiles dentro de la misma plataforma:

  • La interfaz permite buscar términos y filtrar por rango temporal, con resultados tipo gráfico de tendencia y tabla de contextos.
  • La “Guía de uso” explica la sintaxis (términos separados por coma) y el botón “Buscar”; además, describe el acceso a un “Ver PDF” para consultar el diario escaneado en Cultura Digital.
  • La página “Proyecto” presenta la plataforma como un servicio web para consultar un corpus masivo derivado de digitalización de prensa (en particular, asociado al periódico “La Nación”).

Nota de archivo: como algunas páginas cambian (rango de fechas/corpus disponibles), conviene anotar siempre la fecha de consulta y, si es posible, guardar capturas o exportar resultados relevantes.


6) Evidencia Visual – Taller/espacio de investigación (herramientas proyectuales)

Sitio:
https://evidenciavisual.org/#menu

  • Se presenta como un taller para la investigación que trabaja con imágenes como fuente primaria, desarrollando aproximaciones conceptuales/metodológicas/operativas basadas en “herramientas proyectuales”.
  • Declara cruces con arquitectura forense, arqueología de los medios, humanidades digitales, antropología visual, cine verité e historiografía urbana, entre otros.
  • El sitio indica estar en proceso de actualización/mantención (hasta diciembre de 2025); algunos enlaces internos pueden no estar operativos durante ese período.

Expérimentations visuelles des vidéos YouTube

Ce cas d’étude s’inspire directement des méthodologies empiriques issues des recherches sur les plateformes web, et plus spécifiquement des travaux cherchant à décrire la structure de YouTube.

Nous avons étudié les vidéos les plus regardées depuis le lancement de YouTube en 2005, dans l’objectif de concevoir une visualisation interactive web. À partir de la liste officielle « Top Ten » proposée par YouTube , nous avons d’abord noté que les vidéos les plus visionnées sont toutes des clips musicaux. Afin d’élargir notre analyse, nous nous sommes tournés vers une playlist communautaire intitulée « Most Viewed Videos of All Time », publiée par MyTop100Videos, qui recense 532 vidéos cumulant à elle seule plus de 34 milliards de vues.

Méthodologie du cas d’étude : extraction et structuration des données

La première étape de notre démarche a consisté à identifier, collecter et structurer les données nécessaires à notre visualisation interactive. Puisque YouTube ne permet pas directement le téléchargement de ces informations, nous avons analysé le code source HTML de la playlist « Most Viewed Videos of All Time » afin d’en extraire les métadonnées pertinentes (titres, auteurs, nombres de vues, dates et vignettes). Cette approche vise à rendre visible la manière dont l’information est structurée et encodée au sein des pages web.

Pour réaliser cette extraction, nous avons développé un script Python[1], exécuté sur Google Colab, afin de récupérer automatiquement les principales métadonnées associées aux vidéos. Le résultat, accessible en ligne, est enregistré sous la forme d’un fichier CSV[2]. Nous avons ensuite effectué deux opérations complémentaires pour préparer les données à la visualisation. Premièrement, le nombre de vues a été normalisé pour faciliter leur représentation graphique (la vidéo la plus populaire, atteignant 15 milliards de vues, a ainsi été ramenée à une échelle maximale de 1000). Deuxièmement, une analyse colorimétrique des vignettes a été réalisée pour identifier les couleurs dominantes utilisées afin d’attirer l’attention des utilisateurs. Nous avons utilisé à cet effet un second script Python pour télécharger les images[3], puis notre outil Drag & Hue (Reyes, 2024) afin d’extraire leurs valeurs numériques selon les modèles RVB et HSL. Ces deux modèles colorimétriques complémentaires ont permis de générer un ensemble cohérent de six variables numériques, exploitées par une analyse en composantes principales (PCA) réalisée via un troisième script Python[4].

Le recours à cette méthode a également permis de mettre en évidence l’ampleur des médiations techniques propres à YouTube. En effet, l’extraction d’informations telles que les liens, titres, chaînes, vues ou dates de publication nécessite de comprendre les conventions spécifiques adoptées par la plateforme dans son code HTML. Ces conventions sont révélatrices du positionnement de YouTube en tant que média numérique structuré autour d’une logique de recommandation et d’interaction algorithmique. Ainsi, la longueur importante du code HTML d’une seule vidéo issue de la playlist (261 lignes en moyenne, soit plus de 116 000 lignes pour l’ensemble des 532 vidéos étudiées) ne constitue pas seulement un détail technique. Elle témoigne surtout de la stratification complexe du code, résultant des multiples couches d’interfaces, de mesures d’audience, et de gestion automatique des contenus mises en place par YouTube (Liddle, 2023).

Exploration graphique de la visualisation de données

Pour ce cas pratique, nous avons choisi d’utiliser l’élément <canvas> comme support graphique sans avoir recours à des web app ou librairies graphiques, qui tendent à imposer des contraintes sur les modalités visuelles associées aux données. La seule ressource externe employée dans nos prototypes est l’analyseur CSV PapaParse, très répandu pour son efficacité et sa vitesse de traitement.

Nous avons d’abord exploré des représentations simples. Un premier exemple associe chaque vidéo à un cercle dont la couleur dominante reprend celle de sa vignette. Les cercles sont ensuite disposés sous forme tabulaire (figure 1, gauche). Dans un deuxième exemple, le nombre de vues est associé à des points colorés regroupés également sous forme tabulaire (figure 1, droite).

Fig. 1. Deux visualisations du même jeu de données. E. Reyes, 2025

Afin d’exploiter davantage la bidimensionnalité du <canvas>, nous avons ensuite réalisé des représentations plus complexes. La figure 2 (à gauche) présente ainsi un nuage de points organisé en référence au cercle chromatique, où les couleurs les plus saturées sont placées à l’extérieur, et les moins saturées vers le centre. À droite, nous montrons un nuage de nœuds utilisant un algorithme dit de spatial hashing (grille spatiale). Contrairement aux précédentes visualisations, où chaque élément occupe une position fixe et prédéfinie, cet algorithme divise l’espace graphique en cellules afin d’accélérer la détection et d’éviter des superpositions d’éléments visuels. Cette discrétisation spatiale réduit significativement le nombre d’opérations techniques nécessaires à la détection de collisions, accélérant ainsi l’affichage à l’écran.

Fig. 2. Nuage de points et nuages de nœuds. E. Reyes, 2025

Une version interactive du prototype a également été réalisée où chaque cercle peut être cliqué, révélant ainsi une boîte d’information avec les métadonnées associées à la vidéo. Cette version est consultable en ligne[5]. Certes, d’autres variations pourraient être envisagées. Notre objectif est de montrer la flexibilité méthodologique permise par une approche exploratoire.

Références

D. Liddle & J. Sherrill, « Analyzing YouTube Content: Methodological Considerations for Technical Communication Research ». Proceedings of the 41st ACM International Conference on Design of Communication (SIGDOC ’23). ACM Press, 2023. https://doi.org/10.1145/3615335.3623005

E. Reyes, « Drag & Hue (0.1) », Zenodo, 2024. https://doi.org/10.5281/zenodo.13835746


[1] https://colab.research.google.com/drive/13g5QFlxsEhz-szBF4g7Ol5GPgy8epsvL (consulté le 18 mai 2025).

[2] https://nakala.fr/10.34847/nkl.f80cs31m (consulté le 18 mai 2025).

[3] https://colab.research.google.com/drive/1w0HgjWR4ut0Dt6wB4wmYlXuSiudwa8Ml (consulté le 18 mai 2025).

[4] https://colab.research.google.com/drive/149AJ96YUGYrDRpk9w-J9MoDLJBdIMeI6 (consulté le 18 mai 2025).

[5] https://ereyes.github.io/ytviz/ (consulté le 18 mai 2025).